
Ollama anunció que ahora es compatible con modelos de voz en macOS, mientras que el soporte para Windows y Linux llegará próximamente. El primer modelo de voz disponible es Phonon, una familia de modelos pequeños y de vanguardia para texto a voz (TTS, por sus siglas en inglés) desarrollados por Gradium.
De acuerdo con el comunicado, los usuarios deben descargar o actualizar Ollama a la versión 0.40.11 para ejecutar un modelo de voz. Una vez instalada, la herramienta permite generar audio con un comando sencillo como ollama run phonon "Hello from Ollama.". Además, es posible elegir entre docenas de voces mediante el parámetro --voice, por ejemplo: ollama run phonon --voice Hugh "Once upon a time, a little alpaca lived at the top of a very tall mountain."
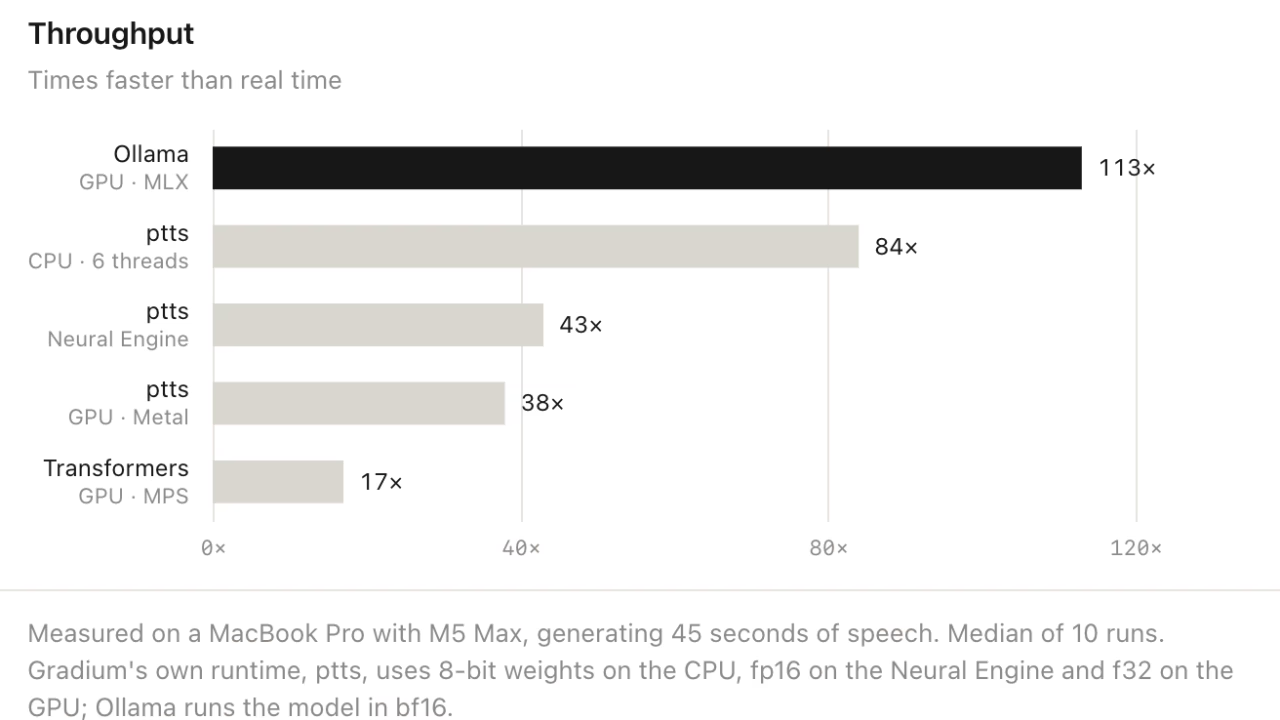
El comunicado destaca que, acelerado por MLX, Ollama ejecuta Phonon un 35% más rápido que la siguiente opción más veloz en una MacBook Pro con M5 Max, con la misma precisión que la implementación de referencia. Las aplicaciones pueden utilizar esta funcionalidad a través del endpoint /v1/audio/speech compatible con OpenAI. También es posible canalizar la respuesta de un modelo de chat y escucharla mientras se escribe, como se muestra en el ejemplo: ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon.
Para conocer las voces y obtener más información, Ollama invita a escuchar ejemplos en su blog, consultar la documentación de voz y visitar la página del modelo Phonon. La empresa señaló que el soporte para Windows y Linux estará disponible próximamente, aunque no especificó fechas.